[aru_34]上一篇把 AI 整理好的文章送进了 WordPress 草稿箱。接着折腾定时执行时,我想先把另一个问题弄明白:如果上一轮还没结束,下一轮又启动了,怎么办?
比如计划任务已经在跑,我又手动点了一次;或者任务每分钟触发,实际却要两分钟才能完成。两份脚本一起请求接口、一起写文件,后面的重复数据就不奇怪了。
我先拿 Python 做了个小实验:同一台机器上,同一份任务一次只允许一个进程进入。用标准库的 fcntl.flock 就能把这一步做出来。
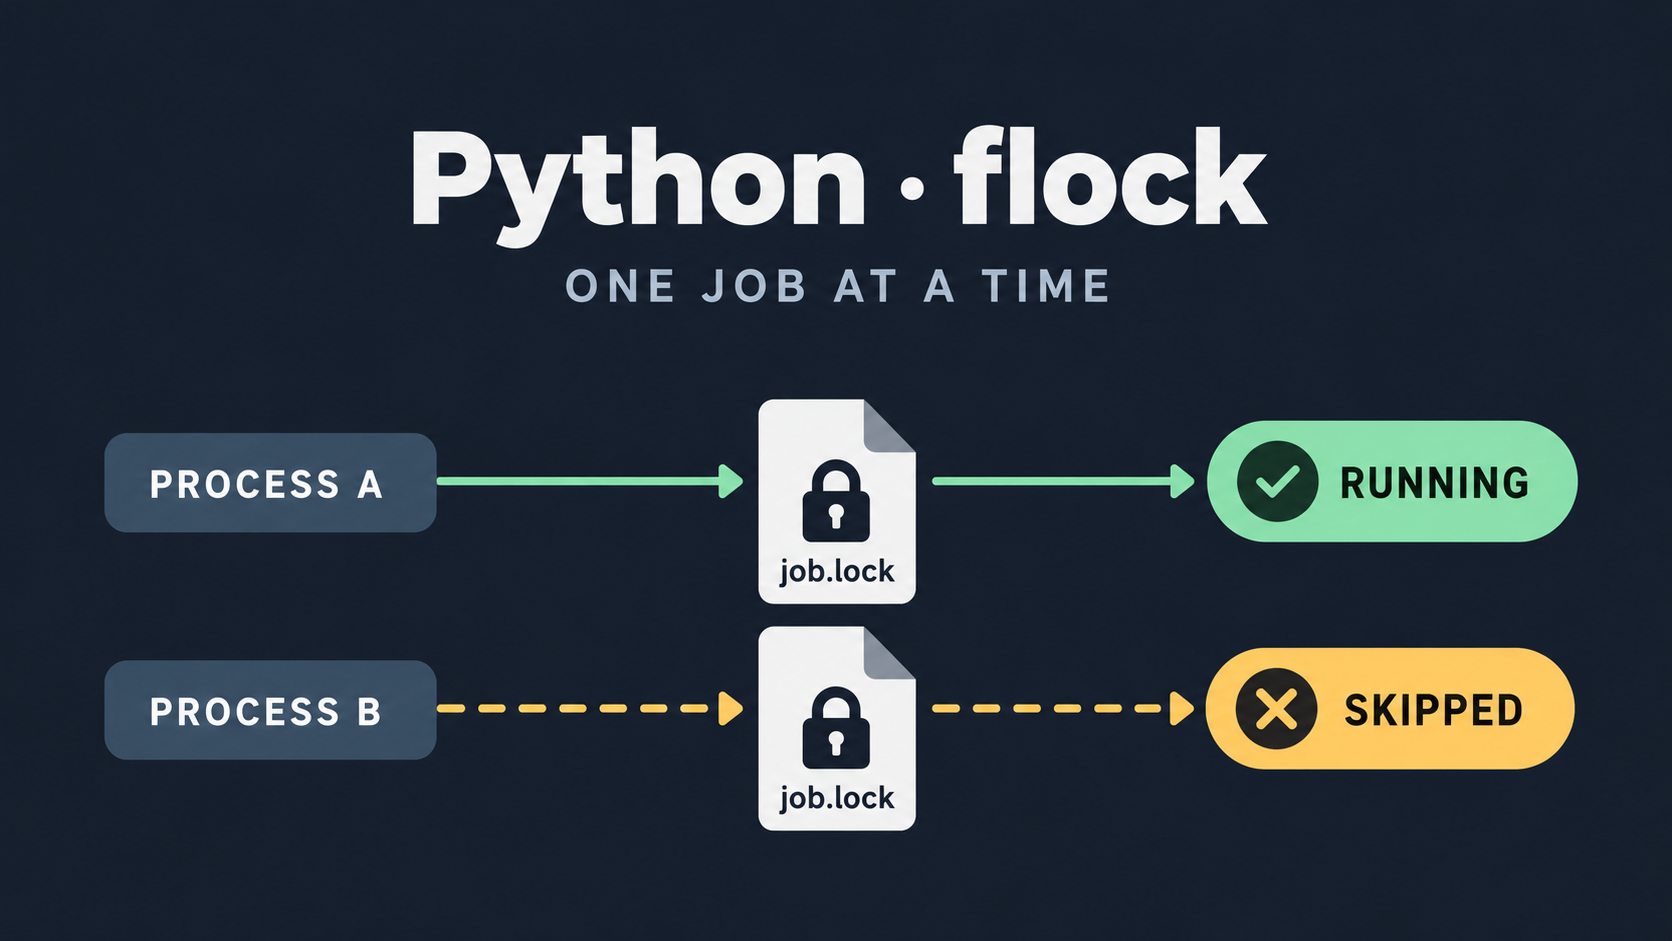
示意图:上下两行的 job.lock 指同一个锁文件路径,A 持锁时 B 跳过;非终端截图。
先别用“文件存在”来判断
很容易想到一个办法:启动时判断有没有 run.lock,没有就创建,结束时删掉。
问题出在“先判断,再创建”是两步。两个进程有可能都看见文件不存在,然后都开始工作。再加上程序异常后文件没删掉,后面还得自己判断这把“锁”到底是不是过期了。
这次我让操作系统管理锁:脚本打开一个固定文件,申请独占锁;拿到锁才工作,拿不到就直接跳过。判断依据是锁是否可获取,文件留在磁盘上也没关系。
先放一份可以直接跑的代码
保存为 single_job.py。本次验证用的是 macOS 和 Python 3.9.6;示例使用 Unix 的 fcntl 接口,不适用于原生 Windows Python。我也核对了 Linux 的接口说明,但这轮没有在 Linux 上实际运行。
import argparse
import errno
import fcntl
import os
from pathlib import Path
import time


def run_job(lock_path, seconds):
    lock_path.parent.mkdir(parents=True, exist_ok=True)
    with lock_path.open("a", encoding="utf-8") as lock_file:
        try:
            fcntl.flock(lock_file, fcntl.LOCK_EX | fcntl.LOCK_NB)
        except OSError as error:
            if error.errno in (errno.EACCES, errno.EAGAIN):
                print("SKIP: 已有实例运行,本次跳过", flush=True)
                return
            raise
        try:
            print(f"RUN: pid={os.getpid()},开始执行", flush=True)
            # 演示耗时任务;实际使用时换成自己的业务代码。
            time.sleep(seconds)
            print("DONE: 本次执行结束", flush=True)
        finally:
            fcntl.flock(lock_file, fcntl.LOCK_UN)
    # 保留锁文件,不要在这里 unlink。


if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    parser.add_argument("--seconds", type=int, default=8)
    parser.add_argument("--lock-file", default=str(
        Path.home() / ".local/state/demo-job/run.lock"
    ))
    args = parser.parse_args()
    if args.seconds < 0:
        parser.error("--seconds 不能小于 0")
    run_job(Path(args.lock_file).expanduser().resolve(), args.seconds)
这里我只放了一个 time.sleep() 模拟耗时操作。实际使用时,把它换成读取资料、处理文件或请求接口的代码,保持这些操作都在持锁范围里面。
几个参数顺手记一下:
LOCK_EX:申请独占锁。LOCK_NB:拿不到就立即返回,不排队等上一轮。LOCK_UN:释放当前锁。
我这里只把 EACCES 和 EAGAIN 当作锁竞争来处理,其他 OSError 继续抛出来。代码按这个规则检查错误号;目录创建、打开文件这类操作失败,也不会被一句“已有实例运行”掩盖。
开两个终端试一下
终端 A 先运行,让任务占着锁等 30 秒:
python3 single_job.py --seconds 30它会打印 RUN 和进程 ID。保持这个终端运行,马上在终端 B 执行:
python3 single_job.py --seconds 0终端 B 应该立即输出:
SKIP: 已有实例运行,本次跳过等 A 结束,再执行一次 B 的命令,就能正常运行。我在本机用临时目录做了同样的双进程验证,下面是其中一组实际输出,PID 每次运行会变:
RUN: pid=51014,开始执行
SKIP: 已有实例运行,本次跳过
DONE: 本次执行结束

RUN: pid=51017,开始执行
DONE: 本次执行结束
这一组自动验证把首个任务的等待时间缩成了 1 秒;上面两条手动命令用 30 秒,是为了留出切换终端的时间。
默认锁文件在 ~/.local/state/demo-job/run.lock。也可以给一份任务明确指定路径:
python3 single_job.py --lock-file "$HOME/.local/state/my-job/run.lock" --seconds 30同一份任务的所有入口都要使用同一个锁路径。手动执行和计划任务如果用不同用户,HOME 也可能不同,最后拿到的是两把锁。把路径设为任务的固定配置,比每次临时拼一个文件名靠谱。
锁文件别顺手删掉
写到 finally 时,很容易想顺手补一句 lock_path.unlink(),清理干净。我专门试了一下,这句反而可能把保护拆了。
假设 A 已经打开并锁住文件,文件被删除后,A 仍然握着原来那个文件对象。B 再按原路径打开,会新建另一个文件对象,申请的是另一把锁。这时两边就都能运行了。
我在临时目录里保持 A 持锁,删除目录项,再启动 B,确实复现了这个现象:文件的 inode 已经变了,B 也打印出了 RUN。所以代码结尾只释放锁、关闭文件,保留 run.lock。
这也说明,锁文件存在并不表示任务还活着。我验证了正常结束、业务代码抛异常,以及直接终止持锁进程这几种情况,之后都能再次启动。这个示例不把文件描述符传给子进程;如果自己扩展成多进程程序,还需要注意描述符是否被继承。
我这次具体检查了什么
- 同一个锁路径,A 运行时 B 会跳过。
- A 正常结束后,B 能运行,锁文件仍然保留。
- 持锁进程被终止后,新的进程能获取锁。
- 模拟业务异常,
finally执行后可以重新获取锁。 - 不同锁文件的任务互不阻塞。
- 持锁时删除文件,会换 inode,并复现绕过原锁的问题。
这些验证都在本机临时目录里完成,没有连接生产接口,也没有拿线上文章做重复写入实验。示例把 SKIP 当作正常跳过,返回码是 0;如果接监控,要从运行记录里区分“执行完成”和“本次跳过”。
它挡住并发,发文去重还得另外做
这把锁只适合我这里讨论的同机、本地文件系统场景。所有执行入口都要主动遵守同一套加锁约定;文件锁不会替我拦住绕开这段代码的程序。多台服务器、容器各自的文件系统或者网络共享盘,也不能直接照搬这个结论。
还有一点和上一篇有关:就算两次发文严格一前一后执行,也可能把同一篇内容创建两遍。文件锁管的是“现在能不能一起跑”,文章去重管的是“这件事是不是已经做过”。
所以后面接发文任务时,我还会记录返回的文章 ID,提交前检查已有草稿;请求超时则先查后台结果,不会因为加了锁就直接重发。
先把单机任务重叠这个问题解决,代码不长,也方便自己以后复制到别的脚本里。真正换成业务代码后,再补上对应的超时、错误记录和去重判断。
这次查的两份资料留在这里:
- Python 3.9:fcntl 文档,核对文件锁接口与相关常量。
- Linux flock(2) 手册,核对锁的关联对象、释放条件,以及网络文件系统的差异。
🎨 原创不易,支持请点赞、转载请注明本文作者为老K