[aru_2]最近几篇都在折腾脚本:防重复运行、保存状态文件。这次我换到 Node.js,补上请求接口时很容易漏掉的一步:超时到底管到哪里?
我想解决的场景很具体:服务端已经发回 200,但 JSON 正文还没传完。如果只等到 fetch() 返回就关掉计时器,后面的 response.json() 仍然可能继续等。
我在本机起了一个故意慢慢发数据的小服务,分别试“响应头慢”和“正文慢”,把复现代码和结果一起记下来。
fetch 返回了,正文不一定读完了
await fetch(url) 拿到的是 Response 对象。读取正文是接下来另一次异步操作,比如 await response.json()。所以我会把一次 JSON 请求看成两步:拿响应、读正文。
下面这段是我想避开的结构示意,url 代表调用方传入的接口地址:
const controller = new AbortController();
const timer = setTimeout(() => controller.abort(), 200);
const response = await fetch(url, { signal: controller.signal });
clearTimeout(timer); // 此时正文可能还没有传完。
const data = await response.json();
如果服务端很快返回响应头,却把最后半截 JSON 留到 1.5 秒以后再发,200 毫秒的计时器就提前被清掉了。我用后面的 /slow-body 路径实际复现:正文最终完整返回,信号一直没有被取消。这不是正文突然变快,而是我设的超时已经失效。
先放一个只做 GET 的小函数
保存为 get-json.mjs。本轮在 macOS、Node.js v22.22.2 上运行,示例按 Node.js 22 环境写,使用内置 fetch,不需要安装第三方包。文件用 .mjs,可以直接使用 ES Module 语法。
export async function getJson(url, { timeoutMs = 3000 } = {}) {
  if (!Number.isInteger(timeoutMs) || timeoutMs <= 0) {
    throw new RangeError('timeoutMs must be a positive integer');
  }
  const signal = AbortSignal.timeout(timeoutMs);
  try {
    const response = await fetch(url, { signal });
    if (!response.ok) {
      await response.body?.cancel();
      throw new Error(`HTTP ${response.status}`);
    }
    return await response.json();
  } catch (error) {
    // A timeout can happen while fetching headers or reading the body.
    if (signal.aborted) throw signal.reason;
    throw error;
  }
}
AbortSignal.timeout(timeoutMs) 返回一个到时会取消的信号。我把它交给 fetch,并且一直等到 response.json() 完成才返回。这里没有在拿到响应头后提前解除超时。
catch 里先看 signal.aborted,是因为读正文阶段发生取消时,底层抛出的错误名称可能与 fetch 阶段不同。这个函数只有自己的超时信号,因此取消后重新抛出 signal.reason,让调用方能统一识别超时;其他网络或 JSON 错误继续保留。
如果后面加了“用户主动取消”,就要再区分取消来源,不能把所有 AbortError 都算成超时。这个小函数目前只负责一次 GET,不包含重试、认证和响应结构校验。
本地造两个“慢接口”
下面保存为 demo-server.mjs。它只监听本机回环地址,避免为了测试去折腾真实接口。
import { createServer } from 'node:http';
import { pathToFileURL } from 'node:url';

export const server = createServer((request, response) => {
  const send = (status, text) => {
    response.writeHead(status, { 'Content-Type': 'application/json' });
    response.end(text);
  };
  if (request.url === '/ok') return send(200, '{"ok":true}');
  if (request.url === '/http-error') return send(503, '{"error":"busy"}');
  if (request.url === '/bad-json') return send(200, 'not json');
  let timer;
  if (request.url === '/slow-headers') {
    timer = setTimeout(() => send(200, '{"ok":true}'), 1500);
  } else if (request.url === '/slow-body') {
    response.writeHead(200, { 'Content-Type': 'application/json' });
    response.flushHeaders();
    response.write('{"ok":');
    timer = setTimeout(() => response.end('true}'), 1500);
  } else {
    return send(404, '{"error":"not found"}');
  }
  response.on('close', () => clearTimeout(timer));
});

if (process.argv[1] && import.meta.url === pathToFileURL(process.argv[1]).href) {
  server.listen(8787, '127.0.0.1', () => {
    console.log('Demo server: http://127.0.0.1:8787');
  });
}
/slow-headers 等 1.5 秒才发响应头;/slow-body 先把 200 响应头和半截 JSON 发出来,再等 1.5 秒补齐。后一个路径正好能检查超时有没有覆盖正文读取。
底部那段 import.meta.url 判断,只在直接执行这个文件时启动 8787 端口;测试程序导入它时,可以另外选空闲端口。
终端 A 启动服务,测试结束后按 Ctrl+C 关闭:
node demo-server.mjs终端 B 新建 try-fetch.mjs,和前两个文件放在同一目录:
import { getJson } from './get-json.mjs';

const path = process.argv[2] ?? '/ok';
try {
  const data = await getJson(`http://127.0.0.1:8787${path}`, {
    timeoutMs: 300,
  });
  console.log(data);
} catch (error) {
  console.error(error.name, error.message);
  process.exitCode = 1;
}
node try-fetch.mjs /ok
node try-fetch.mjs /slow-headers
node try-fetch.mjs /slow-body
node try-fetch.mjs /http-error
node try-fetch.mjs /bad-json正常路径能打印对象;两个慢路径都应该报告 TimeoutError;503 路径会得到 HTTP 503 错误;最后一个路径虽然返回 200,正文却不是合法 JSON,会在解析时抛 SyntaxError。后四条失败是这次演示预期的结果,进程会以非零状态结束。
HTTP 503 也要自己判断
fetch 收到 HTTP 错误状态,不会仅仅因为 404、503 就自动拒绝 Promise,所以函数里单独检查了 response.ok。我只想取成功的 JSON,遇到非成功状态便取消未读取的正文,再抛出带状态码的错误。
这个取舍会丢掉服务端的错误正文。如果业务需要其中的错误码或说明,应在同一个超时约束下读取、限制大小并妥善处理,而不是直接照搬取消正文这一步。
同样,200 也不保证内容符合我需要的数据结构。这里的 json() 只负责 JSON 解析,解析之后还要按业务验证字段。
我这轮具体跑了什么
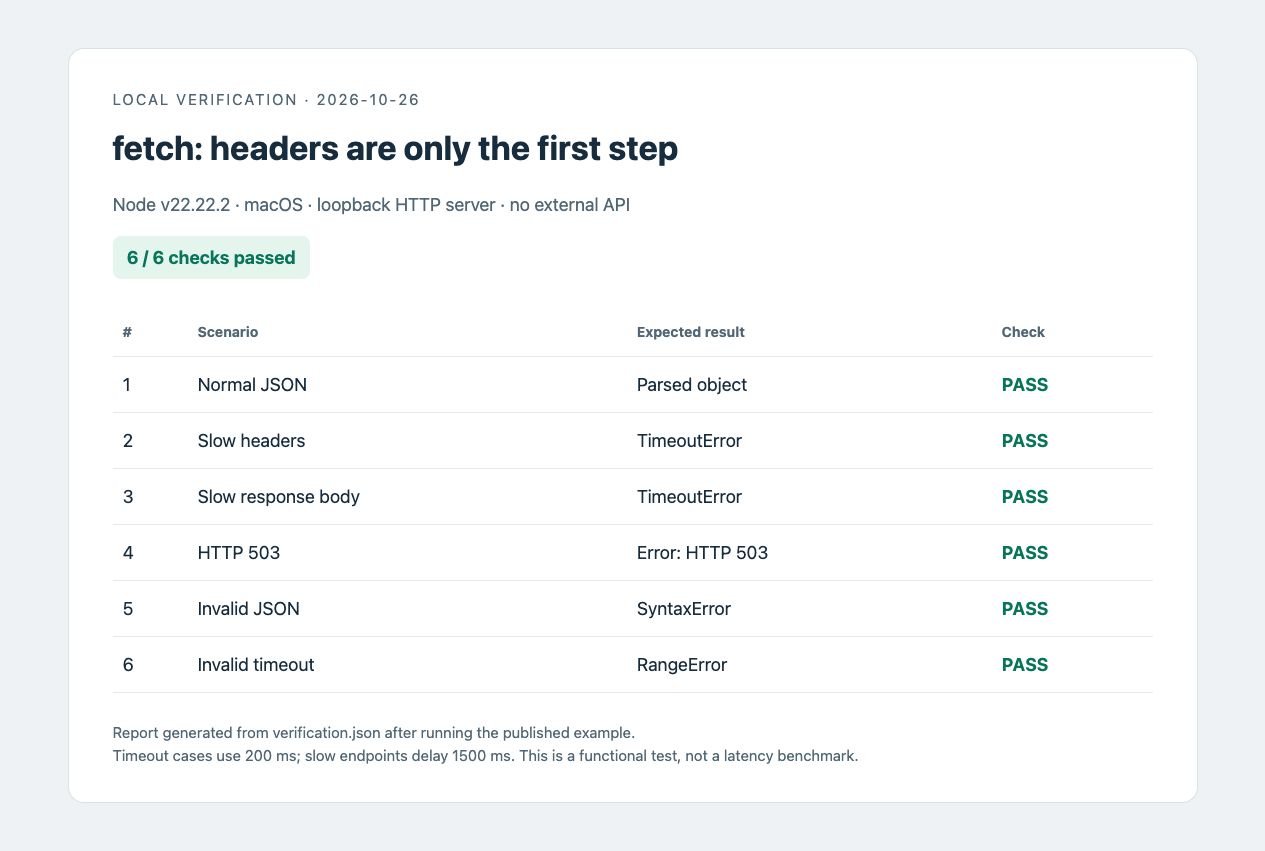
测试服务和调用方都在本机运行,没有连接 WordPress 或其他生产接口。自动验证使用系统分配的空闲端口,慢接口延迟 1500 毫秒,超时检查设为 200 毫秒:
- 正常 JSON 能读到完整对象。
- 响应头迟到时,函数以 TimeoutError 失败。
- 响应头已到但正文迟到时,也以 TimeoutError 失败。
- HTTP 503 被识别为 HTTP 错误。
- 200 配上无效 JSON,保留 SyntaxError。
- timeoutMs 为 0 时,在发请求前拒绝参数并抛 RangeError。
6 项检查全部通过。配图是这些实际测试结果生成的本地报告页面截图,不是线上接口监控,也不是网络性能跑分。上面的手动命令用 300 毫秒,便于和 1500 毫秒的服务端延迟区分;并不是推荐所有接口都设成这个值。
超时以后,先别急着重发
这个函数只是 GET 演示。以后拿它的思路去处理发文章、创建订单之类的写请求时,我会先记住:客户端停止等待,不代表服务端撤销了已经收到的操作。
如果写入请求超时,应该先用业务标识、已有文章 ID 或后台查询确认结果,再决定要不要重试。给请求加了计时器,并不能顺便获得业务去重。
另外,这也不是硬实时计时器:事件循环阻塞时,取消信号可能晚些才被处理;超大正文的内存占用和解析耗时,还需要另外限制。这轮没有模拟 DNS、TLS 握手、断网和其他操作系统,结论只覆盖本地 HTTP 服务的这些路径。
我这次留下的检查顺序是:先看 HTTP 状态,再把正文读完;一次请求的等待边界,要从发起一直覆盖到需要的数据真正到手。
核对资料放在这里,方便以后回来查:
- Node.js 22 文档:AbortSignal.timeout(),以及同页的 fetch 与 signal.reason。
- MDN:Using the Fetch API,核对响应状态、正文读取与取消行为。
🎨 原创不易,支持请点赞、转载请注明本文作者为老K