[aru_21] 假设我要把供应商导出的商品 CSV 导入本地 SQLite:第一次只处理了一部分,下次再运行,希望从已经提交的位置继续。关键不只是记录“读到了哪里”,还得让进度与实际写入的数据保持一致。这次我做一个可以按批次暂停、继续的小脚本,再用进程中断验证它的回滚行为。
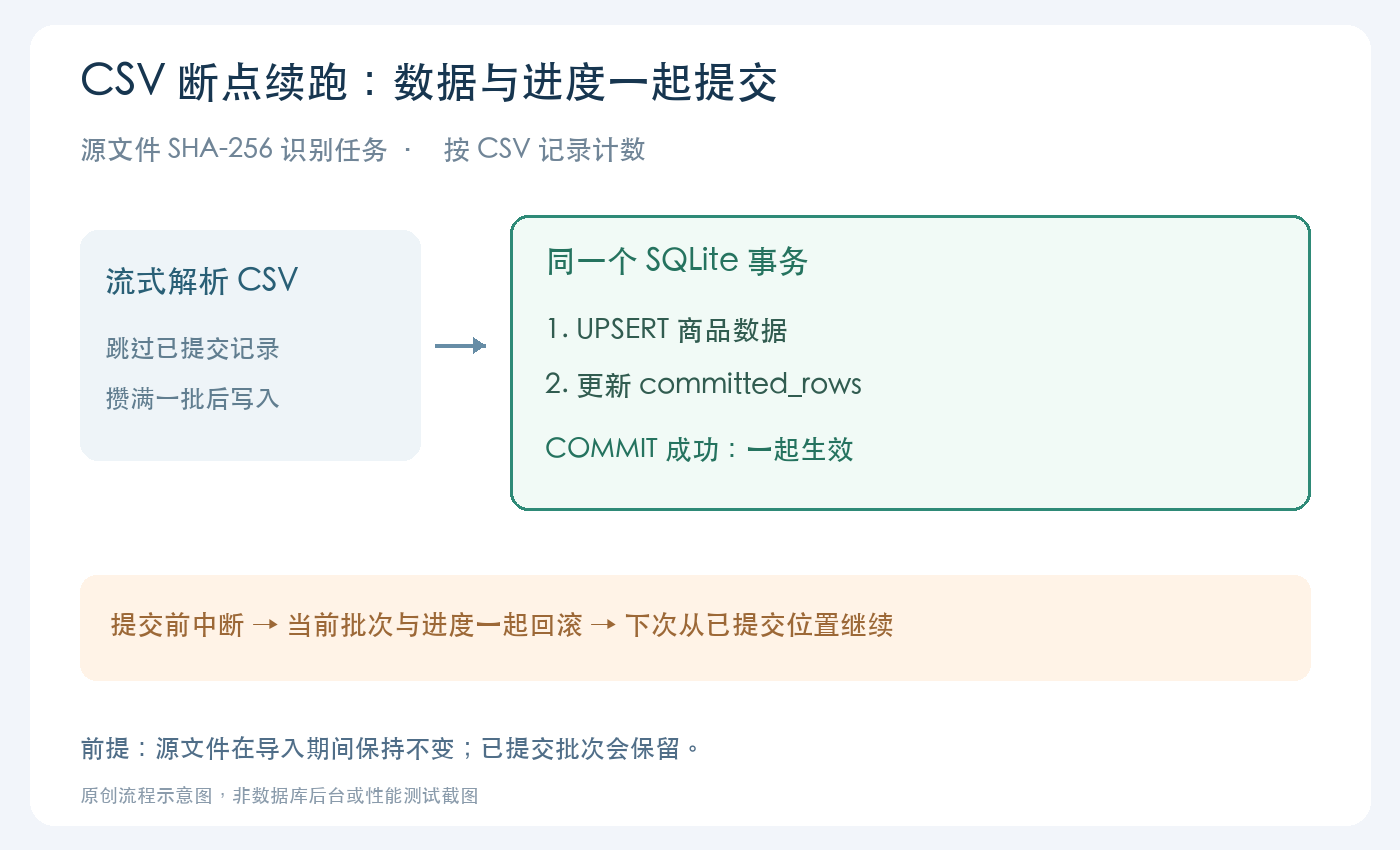
示例针对本地、不可变的 UTF-8 商品快照,使用 Python 标准库,不依赖 pandas。它把当前批次的数据和进度写在同一个数据库事务里;已经提交的批次会保留,未提交的批次下次重做。
先确定导入的业务语义
我把 SKU 当作商品主键,名称和价格按 CSV 中的值更新;价格用整数分,避免在导入代码里处理小数金额。同一份文件如果有重复 SKU,后出现的记录覆盖前面的值。因此“处理了五条 CSV 记录”不一定等于“数据库里有五件商品”。
这是一种合并更新:文件中没有出现的旧商品不会被删除。如果业务要求整批替换,应该用暂存表验证完整数据后再切换,不能直接套用这里的 UPSERT 语义。
为什么进度不能单独写进 JSON?
假如先提交商品,再保存进度,进程刚好在两步之间退出,下次会重复处理这一批;反过来先存进度再写商品,又可能跳过尚未写入的数据。这里我把进度表与商品表放在同一个 SQLite 文件中,一次事务同时更新两者。
另外,CSV 的“第几行”容易产生歧义。名称字段可以包含带引号的换行,所以我记录的是 csv.DictReader 解析出的逻辑记录数,不是文本物理行数,也不拿字符串 split(',') 解析 CSV。文件以 newline='' 打开,让 csv 模块处理字段中的换行。
完整脚本:import_csv.py
保存下面文件即可运行。每次开始先计算源文件 SHA-256,把它作为导入任务标识;内容改变会形成新任务,从头扫描并合并更新。导入过程中必须保证源文件不被其他程序改写,最好对导出完成的固定快照操作。
import argparse
import csv
import hashlib
import re
import sqlite3
from contextlib import closing


def fingerprint(path):
    digest = hashlib.sha256()
    with open(path, 'rb') as stream:
        for chunk in iter(lambda: stream.read(1024 * 1024), b''):
            digest.update(chunk)
    return digest.hexdigest()


def import_csv(source, database, batch_size=1000, max_batches=None):
    if batch_size < 1 or (max_batches is not None and max_batches < 1):
        raise ValueError('batch_size and max_batches must be positive')
    # 前提:导入期间源文件不可修改;更换文件后会建立新的进度。
    job = fingerprint(source)
    with closing(sqlite3.connect(database, isolation_level=None, timeout=5)) as db:
        db.executescript('''
            CREATE TABLE IF NOT EXISTS products (
                sku TEXT PRIMARY KEY, name TEXT NOT NULL,
                price_cents INTEGER NOT NULL CHECK(price_cents >= 0)
            );
            CREATE TABLE IF NOT EXISTS imports (
                digest TEXT PRIMARY KEY, committed_rows INTEGER NOT NULL
            );
        ''')
        db.execute('INSERT OR IGNORE INTO imports VALUES (?,0)', (job,))
        done = db.execute('SELECT committed_rows FROM imports WHERE digest=?', (job,)).fetchone()[0]
        start, batches = done, 0

        def flush(rows):
            nonlocal done, batches
            with db:
                db.execute('BEGIN IMMEDIATE')
                current = db.execute('SELECT committed_rows FROM imports WHERE digest=?', (job,)).fetchone()[0]
                if current != done:
                    raise RuntimeError('progress changed; stop and run again')
                db.executemany('''
                    INSERT INTO products VALUES (?,?,?)
                    ON CONFLICT(sku) DO UPDATE SET
                        name=excluded.name, price_cents=excluded.price_cents
                ''', rows)
                db.execute('UPDATE imports SET committed_rows=? WHERE digest=?', (done + len(rows), job))
            # 只有事务提交成功,才推进内存进度。
            done += len(rows)
            batches += 1

        with open(source, encoding='utf-8-sig', newline='') as stream:
            reader = csv.DictReader(stream, strict=True)
            if reader.fieldnames != ['sku', 'name', 'price_cents']:
                raise ValueError('expected header: sku,name,price_cents')
            batch = []
            for index, row in enumerate(reader, 1):
                if index <= done:
                    continue
                if (None in row or any(v is None for v in row.values()) or
                    not row['sku'].strip() or not row['name'].strip() or
                    not re.fullmatch(r'[0-9]{1,12}', row['price_cents'])):
                    raise ValueError('invalid CSV record {}'.format(index))
                batch.append((row['sku'].strip(), row['name'].strip(), int(row['price_cents'])))
                if len(batch) == batch_size:
                    flush(batch)
                    batch = []
                    if max_batches is not None and batches >= max_batches:
                        break
            else:
                if batch:
                    flush(batch)
        return {'committed_records': done, 'new_records': done - start, 'batches': batches}


if __name__ == '__main__':
    parser = argparse.ArgumentParser()
    parser.add_argument('csv_file')
    parser.add_argument('database')
    parser.add_argument('--batch-size', type=int, default=1000)
    parser.add_argument('--max-batches', type=int)
    args = parser.parse_args()
    print(import_csv(args.csv_file, args.database, args.batch_size, args.max_batches))
这里用 isolation_level=None 关闭隐式开启事务,再在每次 flush 时显式 BEGIN IMMEDIATE。连接的 with 块负责提交或回滚已经开启的事务,外层 closing 则负责关闭连接。这让代码里“每批什么时候开始、什么时候生效”比较容易核对。
批次开始时还会重新读取进度,若发现别的写入者已推进,就停止本次导入,避免用旧进度覆盖新值。它不是多工作进程调度器,实际使用仍建议同一数据库一次只运行一个导入任务。
用五条记录跑一次暂停和继续
新建 products.csv:
sku,name,price_cents
A,第一件商品,100
B,第二件商品,200
C,第三件商品,300
D,第四件商品,400
E,第五件商品,500
在一个新的实验目录运行,先只提交一批,两条记录:
python3 import_csv.py products.csv demo.sqlite --batch-size 2 --max-batches 1
# 输出:committed_records=2, new_records=2, batches=1

python3 import_csv.py products.csv demo.sqlite --batch-size 2
# 输出:committed_records=5, new_records=3, batches=2

python3 import_csv.py products.csv demo.sqlite --batch-size 2
# 输出:committed_records=5, new_records=0, batches=0
脚本实际打印的是包含这些字段的字典。max-batches 适合把一次运行的工作量限定在若干批;不指定时会处理到文件结尾。第三次运行同样会读取和解析文件,但不会再次写入已经提交的记录。
遇到坏记录,哪些内容会保留下来?
示例要求固定表头,SKU 与名称非空,price_cents 为 1–12 位非负整数字符。字段缺失、字段多出或非法价格都会报错,并给出逻辑记录编号。它不把坏数据静默吞掉。
如果一批中前面有合法记录、后面出现坏记录,这批尚未 flush 的内存数据不会写入;如果写入事务本身发生异常,当前批次和它的进度一起回滚。更早已成功提交的批次保留。因此它提供的是“每批一致”,整个文件不是一个不可分割的大事务。
修改坏记录后,文件哈希会改变,恢复时将按新任务从头合并更新,而不是沿用旧文件的记录编号。这是有意的选择:同一路径不代表同一份数据,改动文件后继续套旧进度可能漏掉前面的修改。
我怎样验证中断,而不只看正常输出
本轮在 macOS 上分别使用 Python 3.9.6 / SQLite 3.51.0 和 Python 3.12.14 / SQLite 3.53.1 运行了六组检查,两套环境均通过。Python 3.9 已停止支持,部署应使用受支持的版本;这里保留旧环境结果,只用于说明实际验证范围。
| 检查 | 实际结果 |
|---|---|
| 首批两条记录,名称中包含字段内换行 | 进度为 2,商品数为 2 |
| 子进程在事务中同时修改数据和进度,COMMIT 前 os._exit() | 重开数据库后,数据与进度都回到上一批提交值 |
| 继续运行,再重复运行 | 先补入剩余 3 条,再运行新增 0 条 |
| 修改源文件中的同一个 SKU | 新任务更新该 SKU,文件缺少的旧商品保留 |
| 批次中出现负数价格 | 拒绝该批次,进度保持为 0,没有部分商品混入 |
| 两条记录使用相同 SKU | 进度增加 2,商品只增加 1,后值覆盖前值 |
中断测试是在独立子进程中对同一套商品表和进度表开启事务、修改后硬退出,再由父进程重开数据库核对,并非假装执行了断电测试。它验证了本机这个事务回滚场景,不能代替磁盘、文件系统或网络存储的可靠性验证。
数据量变大后,还需要改哪里
这份实现把内存占用限制在一个批次的解析结果附近,但没有做到直接跳到文件字节偏移:每次都要完整算一次文件哈希,再从头解析并跳过已提交的记录。恢复成本会随文件大小增长,不适合把它描述成恒定时间续跑,也没有做百万行吞吐测量。
对于更大的数据集,可以让上游按稳定批次切分文件,并给每个分片分配独立版本标识;或者把已验证的数据先放进暂存表。一个 CSV 字段也可能非常大,生产导入还应按数据契约限制字段和记录长度,并明确编码、空白和主键规范。
进度只描述本脚本对这份文件已经提交的位置。如果之后手工删除商品或让其他任务覆盖了它,再运行同一份文件不会自动修复数据库。要做“重新对账”必须显式创建新的导入版本或另设计校验流程,不能把断点进度当作目标数据永远正确的证明。
我会先用它处理一次性、本地的商品快照合并:固定源文件、确认主键语义,再用小批次演练中断。恢复的依据应是已提交的数据,而不是终端最后打印到了哪一行。
参考:Python:sqlite3 事务与连接管理、Python:csv 模块、SQLite:UPSERT、SQLite:原子提交。
🎨 原创不易,支持请点赞、转载请注明本文作者为老K