[aru_32] 假设后台有个“按天统计订单”的接口,用户选择上海时间的 11 月 2 日,数据库却按 UTC 的 11 月 2 日查询。页面能正常返回,数量甚至可能看起来没变,但订单和金额已经错了。这次我用一个本地小项目,把业务边界、失败测试和修复约束一起交给 AI,再核对它究竟修对了什么。
本文旧代码是本轮为教学刻意构造的缺陷,不是我遇到过的线上事故。示例只操作内存 SQLite,不调用模型 API;提示词可以复制给能读取本地文件、修改代码并运行终端的 AI 编程助手使用。代码包包含修复前后实现和全部测试。
完整实验文件:下载时区回归测试实验包(ZIP,含修复前后代码、十项测试和提示词)。建议使用 Python 3.12;本轮在 macOS / Python 3.12.14 跑通,也用已有的 Python 3.9.6 环境交叉检查。zoneinfo 需要系统 IANA 时区数据或官方维护的 tzdata 包;缺数据的环境应先在自己的虚拟环境安装 tzdata,不能把缺少数据库误判成算法错误。
第一步:先写清“这一天”到底是哪一天
我先固定业务契约:接口传入 YYYY-MM-DD 和 IANA 时区名,数据库 created_at 是 UTC Unix 整数秒,只统计 paid 订单,返回 count 和 total_cents。这里保留旧接口按“创建时间”筛选已支付订单的语义;如果产品实际要的是“当天支付”,就该另行确认是否改用 paid_at,而不能让 AI 偷偷替产品做这个决定。
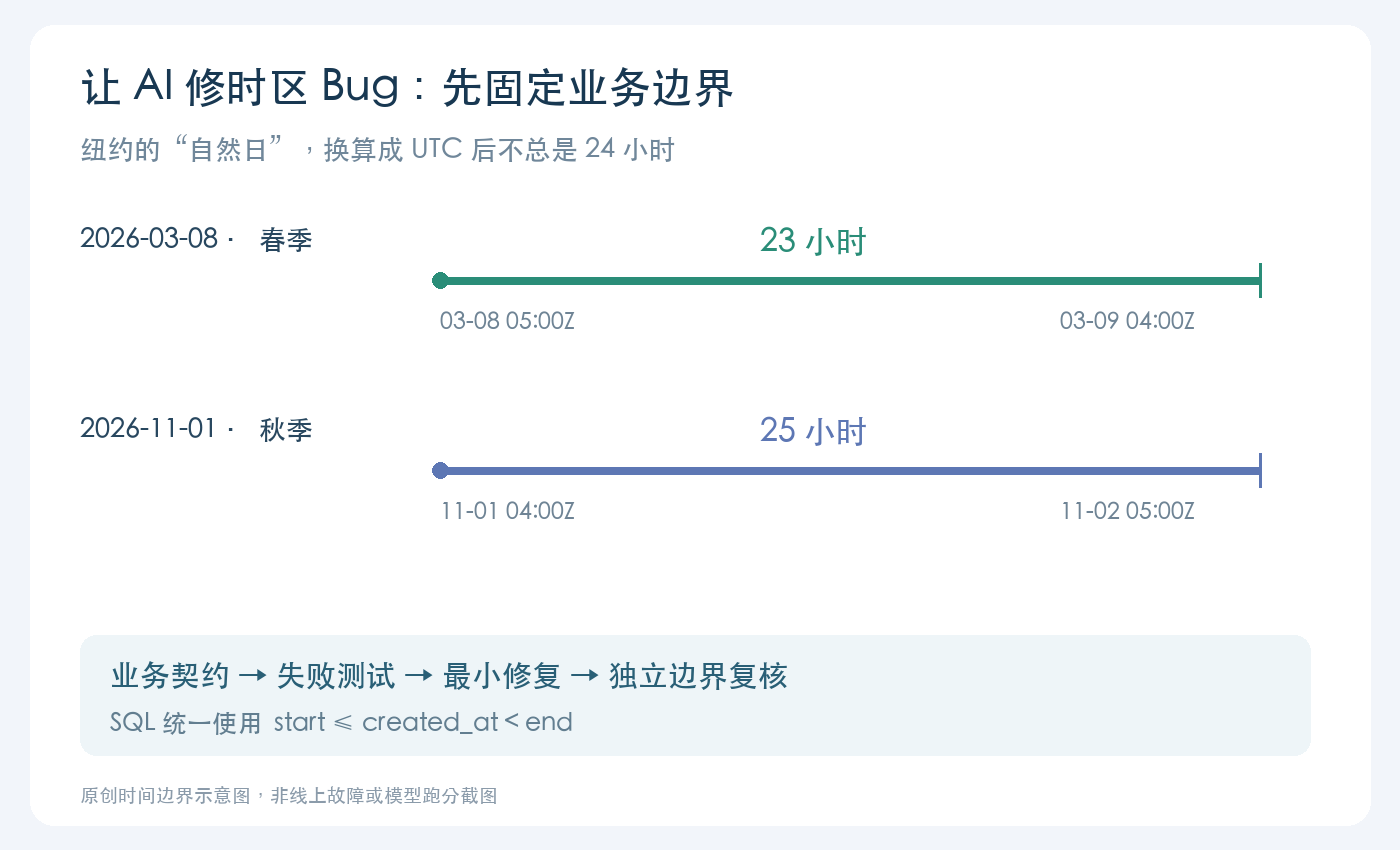
上海的 2026-11-02,对应 UTC 区间是 11 月 1 日 16:00 到 11 月 2 日 16:00,右端点不包含。边界前一秒、边界本身、次日零点,应该属于哪份报表,必须在写修复前说明白。
我会先给 AI 这一段任务:
请先分析 report.py 和 test_report.py,暂时不要修改实现。
场景:后台按用户指定的本地日期统计订单。
数据:created_at 为 UTC Unix 秒;只统计 status=paid;金额为整数分。
保持 daily_report(db, day_text, zone='Asia/Shanghai') 的参数和返回键不变。
请指出日期、时区、SQL 区间的契约,列出可核对的 UTC 边界。
先运行测试并记录失败,不要把期望值改成旧代码的输出。
这种提问把输出从“解释一下时区”变成了“围绕已有接口拿出可验证边界”。如果 AI 只给一段新代码,没有实际执行测试,我会继续要求它给出命令、退出结果和失败原因。
第二步:用最小旧代码复现,而不是上传整套生产项目
实验包中的 report-before.py 有两个刻意保留的问题:忽略 zone,把本地日期当成 UTC;SQL 把下一天零点也算进来。它的函数名和返回结构都与修复版一致。
from datetime import date, datetime, time, timedelta, timezone


def day_window(day_text, zone='Asia/Shanghai'):
    # 故意保留的教学缺陷:把业务日期当成 UTC 日期。
    day = date.fromisoformat(day_text)
    start = datetime.combine(day, time.min, timezone.utc)
    return int(start.timestamp()), int((start + timedelta(days=1)).timestamp())


def daily_report(db, day_text, zone='Asia/Shanghai'):
    start, end = day_window(day_text, zone)
    row = db.execute('''
        SELECT COUNT(*), COALESCE(SUM(paid_cents),0) FROM orders
        WHERE status='paid' AND created_at >= ? AND created_at <= ?
    ''', (start, end)).fetchone()
    return {'count': row[0], 'total_cents': row[1]}
下载解压后进入 ai-timezone-lab 目录,先保留修复版,再切回旧实现:
cp report.py report-fixed.py
cp report-before.py report.py
python3 -m unittest -v test_report
这里退出码非零是预期结果。本轮第一组 8 项测试有 6 项失败。上海边界用例尤其有意思:两边都统计出 2 单,旧代码的金额却是 1199 分,正确期望是 300 分。只验数量或只看接口没报错,很容易把它放过去。
测试中的订单全部是虚构数据。我把测试留在独立文件里,并先审查了 UTC 期望值;不能允许 AI 为了变绿,把正确的业务期望改成错误实现的输出。测试同样需要评审,不是模型生成以后就自动可信。
第三步:给 AI 足够具体的修复约束
时区问题常见的半修复是“上海减 8 小时”,或者“算出 UTC 开始时间后加 24 小时”。它可能碰巧通过普通日期,却过不了夏令时日期。我给第二阶段的约束如下:
现在只修复 report.py,保持现有测试不变。
以 IANA 时区分别确定当天与次日的本地午夜,再转换成 UTC。
SQL 使用左闭右开区间,不能固定加 86400 秒。
遇到无效日期、未知时区、缺失或重复的午夜,明确拒绝,不猜测。
不增加网络调用,不连接线上库,不改金额和 paid 状态的业务规则。
完成后运行 python3 -m unittest -v test_report,说明实际结果与限制。
以纽约为例,2026-03-08 的两个本地午夜转换成 UTC 后,相差 23 小时;2026-11-01 则相差 25 小时。我的测试直接断言两端的 UTC 时间戳,不只是断言返回值像个整数。
修复后的 report.py
完整测试和建表夹具在实验包中,下面是可直接替换的实现:
import re
from datetime import date, datetime, time, timedelta, timezone
from zoneinfo import ZoneInfo, ZoneInfoNotFoundError


def _midnight_utc(day, zone):
    wall = datetime.combine(day, time.min)
    candidates = set()
    for fold in (0, 1):
        local = wall.replace(tzinfo=zone, fold=fold)
        instant = local.astimezone(timezone.utc)
        if instant.astimezone(zone).replace(tzinfo=None) == wall:
            candidates.add(int(instant.timestamp()))
    # 不猜测历史时区中缺失或重复的午夜,交给业务明确策略。
    if len(candidates) != 1:
        raise ValueError('local midnight is missing or ambiguous')
    return candidates.pop()


def day_window(day_text, zone='Asia/Shanghai'):
    if not isinstance(day_text, str) or not re.fullmatch(r'[0-9]{4}-[0-9]{2}-[0-9]{2}', day_text):
        raise ValueError('expected YYYY-MM-DD')
    try:
        day = date.fromisoformat(day_text)
        next_day = day + timedelta(days=1)
        tz = ZoneInfo(zone)
    except (ValueError, OverflowError, ZoneInfoNotFoundError) as error:
        raise ValueError('invalid date or IANA time zone') from error
    # 分别转换两个本地午夜,不能用 start + 86400 代替。
    return _midnight_utc(day, tz), _midnight_utc(next_day, tz)


def daily_report(db, day_text, zone='Asia/Shanghai'):
    start, end = day_window(day_text, zone)
    row = db.execute('''
        SELECT COUNT(*), COALESCE(SUM(paid_cents),0) FROM orders
        WHERE status='paid' AND created_at >= ? AND created_at < ?
    ''', (start, end)).fetchone()
    return {'count': row[0], 'total_cents': row[1]}
核心路径很短:先得到本地日期,再分别解析当天和次日的午夜,最后把两个边界转成 UTC 秒,交给参数化 SQL。区间使用 created_at >= start 且 created_at < end,相邻两天就不会重复统计边界上的订单。
_midnight_utc 比普通示例多做了一步往返核对:把 fold=0 和 fold=1 对应的候选时刻转到 UTC 再转回来。没有候选说明这个本地午夜不存在;存在两个不同候选说明它有歧义。本例统一拒绝这些边界,交由业务制定策略,而不是悄悄挑一个。
这不是声称所有地区的历史自然日都可以用一个简单区间处理。比如 Pacific/Apia 的 2011-12-30 是跳过的日期;本例选择报错。真实 API 应把这类 ValueError 映射为明确的参数错误响应,不要随意转成“当天没有订单”。
第四步:做一轮独立评审,再看 diff
第一轮修复通过原有 8 项后,我另外检查了纽约秋季两次不同的 01:30,以及历史上有歧义的午夜,形成 test_review.py 的两项补充测试。对应的复用提示词是:
从评审角度检查修复,先不要改实现或已有测试。
独立检查:纽约秋季重复出现的两次 01:30 是否都能计入;
历史时区中有歧义的午夜是否按约定拒绝。
把新增用例写入 test_review.py,运行两组测试。
检查 diff,确认没有改返回结构、统计状态或金额单位。
这里的“独立”指新增用例的检查视角,不是另开一个模型测评,也没有把同一模型自检当成绝对保证。对高风险业务,可以让同事审查,或使用另一位评审者;不论谁评审,最终仍要核对代码、业务语义和实际执行结果。
在自己的仓库里,我会执行 git diff -- report.py test_report.py test_review.py,重点看它有没有改测试期望、放宽校验、改 paid 的筛选,或者把金额单位从分换成浮点数。本文实验包本身不附带 Git 历史,可以把两个实现文件放到比较工具里查看。
本轮实际验证结果
| 阶段 | 结果 |
|---|---|
| 旧实现跑初始测试 | 8 项中 6 项失败 |
| 修复后跑同一组测试 | 8 项全部通过 |
| 加入两项评审用例 | 10 项全部通过 |
测试覆盖空结果及响应结构、上海午夜边界、纽约 23/25 小时自然日、相邻报表去重、无效输入、被跳过的日期、重复小时内两笔订单,以及有歧义的午夜。最终十项在 Python 3.9.6 和 3.12.14 均通过;Python 3.9 已停止支持,新项目应选受支持版本。它们不代表我验证了全部 IANA 时区、全部历史日期或生产环境。
如果想先确认下载包可运行,保留它原本的修复版即可执行:
python3 -m unittest -v test_report test_review
# Ran 10 tests ... OK
放回实际项目时,我还会核对什么
先看真实时间字段的单位和来源:毫秒不能直接当秒,无时区字符串也不能擅自贴上 UTC 标签。把解析后的 UTC 区间交给数据库过滤通常比把整表拉进 Python 再逐条转换更合适,但索引选择仍需结合真实数据库和查询计划验证,本文没有做线上性能测试。
再看时区是谁决定的:应该来自经过校验的用户或组织设置,而不是部署服务器的本地时区。时区规则会变化,多个运行环境也要保持时区数据维护一致。若产品要支持缺失或重复的午夜,需要先补充业务约定和测试,再修改这里的拒绝策略。
这次我更想保留的 AI 编程方法是:先把业务语义和反例留在仓库里,让 AI 面对失败证据做小范围修改,再用独立边界和 diff 核对。这样交付物不只有“模型说修好了”,还包括下一次能重复运行的验收标准。
实验包再次放在这里:下载时区回归测试实验包(ZIP,含修复前后代码、十项测试和提示词)。参考:Python:zoneinfo、Python:datetime。关于要求 AI 实际测试并验证修改,也可对照 OpenAI 官方提示工程文档,本文流程与具体实验由本轮任务整理。
🎨 原创不易,支持请点赞、转载请注明本文作者为老K