[aru_56] 假设我要把一批商品资料、工单详情或文章元数据从接口同步到本地。只发一个请求不难,麻烦的是一批任务里混着慢响应、限流和坏数据:全部同时发容易把接口压满,一个个等又浪费时间。这次我把“有限并发、有限重试、失败单独补跑”拼成一个可运行的小工具。
下面使用本机模拟接口,故意制造 429、503、404 和无效 JSON,再观察采集器怎么处理。它不连接真实业务系统;本地验证环境为 Node.js v22.22.2,无需安装 npm 依赖。
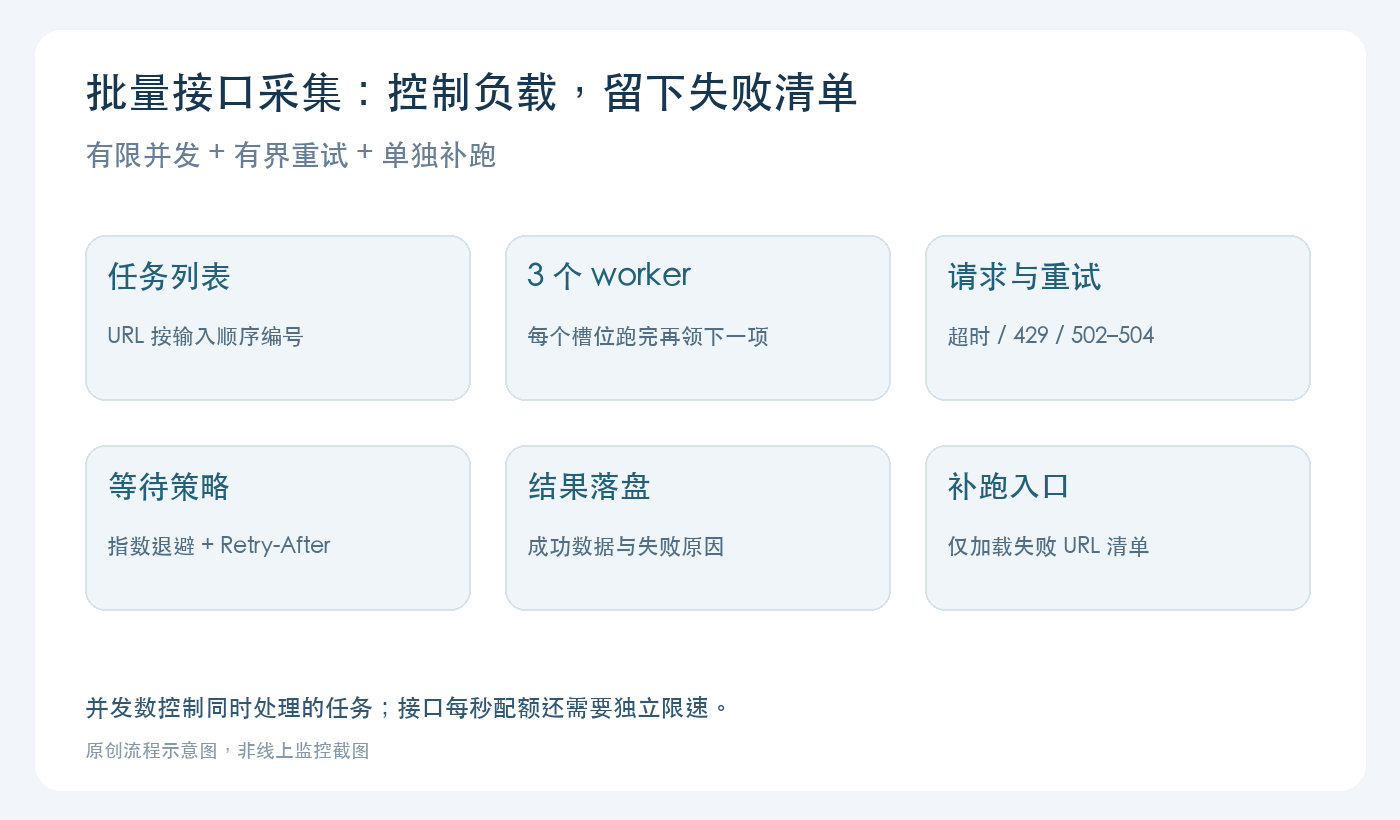
先定清楚三个约束
我把任务限定为只读 GET:每个 URL 最多尝试 3 次,每次请求最多 2 秒,每个任务从被 worker 领取开始最多花 10 秒。等待重试也算在这 10 秒里;在队列中尚未被领取的时间不算。整个批次没有另外设置总时限。
并发控制的是“同时有多少个任务在处理”,包括正在等重试的任务。它不是每秒请求数限制,也不是跨进程的配额管理。这样的实现会让退避中的任务占住槽位,吞吐未必最高,但不会因为某批失败任务在重试时又额外放出一批请求。
第一步:实现采集器 client.mjs
worker 只在当前任务结束以后领取下一项。游标的读取和递增之间没有 await,因此在这一个 JavaScript 进程内,同一位置不会被两个 worker 领取。结果写回原来的索引,完成顺序变化也不影响 URL 与结果的对应。
import { setTimeout as sleep } from 'node:timers/promises';

const retryable = new Set([429, 502, 503, 504]);

export function retryAfterMs(value, now = Date.now()) {
  if (value === null) return null;
  if (/^\d+$/.test(value.trim())) return Number(value) * 1000;
  const time = Date.parse(value);
  return Number.isFinite(time) ? Math.max(0, time - now) : null;
}

export async function getJSON(url, {
  attempts = 3, timeoutMs = 2000, budgetMs = 10000,
} = {}) {
  if (!Number.isInteger(attempts) || attempts < 1 ||
      !Number.isInteger(timeoutMs) || timeoutMs < 1 ||
      !Number.isInteger(budgetMs) || budgetMs < 1) {
    throw new Error('invalid retry options');
  }
  const deadline = performance.now() + budgetMs;
  for (let attempt = 1; attempt <= attempts; attempt++) {
    const left = Math.floor(deadline - performance.now());
    if (left < 1) throw new Error('task budget exceeded');
    const signal = AbortSignal.timeout(Math.min(timeoutMs, left));
    let wait = null;
    try {
      const response = await fetch(url, { signal, redirect: 'error' });
      if (response.ok) return await response.json();
      const status = response.status;
      const advised = retryAfterMs(response.headers.get('retry-after'));
      // 不消费无用错误页,及时释放响应体。
      await response.body?.cancel();
      if (!retryable.has(status) || attempt === attempts) {
        throw new Error(`HTTP ${status} (attempt ${attempt})`);
      }
      wait = advised;
    } catch (error) {
      // 仅重试这次请求自身的超时;JSON、重定向等错误直接上抛。
      if (!signal.aborted || signal.reason?.name !== 'TimeoutError') throw error;
      if (attempt === attempts) throw new Error(`timeout after ${attempt} attempts`);
    }
    const backoff = 200 * 2 ** (attempt - 1) + Math.floor(Math.random() * 100);
    const delay = Math.max(wait ?? 0, backoff);
    if (!Number.isFinite(delay) || delay >= deadline - performance.now()) {
      throw new Error('retry delay exceeds task budget');
    }
    await sleep(delay);
  }
}

export async function collect(urls, { concurrency = 3, ...options } = {}) {
  if (!Number.isInteger(concurrency) || concurrency < 1) {
    throw new Error('concurrency must be a positive integer');
  }
  let cursor = 0;
  const results = new Array(urls.length);
  async function worker() {
    while (cursor < urls.length) {
      const index = cursor++;
      const url = urls[index];
      try {
        results[index] = { url, ok: true, data: await getJSON(url, options) };
      } catch (error) {
        results[index] = { url, ok: false, error: String(error.message ?? error) };
      }
    }
  }
  await Promise.all(Array.from({ length: Math.min(concurrency, urls.length) }, worker));
  return results;
}
这里我只让 429、502、503、504 以及请求自身的超时进入重试。404、JSON 解析错误、网络 TypeError 和重定向错误直接记为失败。真实接口可以根据它的契约细化网络错误分类,不能简单对所有异常无限重试。
Retry-After 支持秒数和 HTTP 日期。退避取它与指数退避加随机抖动的较大值,防止比服务端建议更早重试;如果等待时间超过任务剩余预算,就结束这个任务并记下原因。HTTP 日期受本机时钟准确度影响;示例未补偿客户端与服务器的时钟差。
错误响应体不再使用,先 cancel 再等待重试;成功响应则在同一个 AbortSignal 下读取 JSON。上一篇 fetch 超时笔记解释过响应头和正文的区别,这里把它用于完整任务。
第二步:搭一个会失败的 mock.mjs
与其拿线上接口碰运气,我更愿意先用可控的故障验证逻辑。这个服务只监听 127.0.0.1;/limited 第一次返回 429 并要求等待 1 秒,第二次成功;/busy 始终返回 503,另有 404、无效 JSON 和慢响应。
import http from 'node:http';
import { fileURLToPath } from 'node:url';
import { resolve } from 'node:path';

export function createMock() {
  const counts = new Map();
  let active = 0, peak = 0;
  const server = http.createServer((req, res) => {
    const path = req.url;
    const count = (counts.get(path) ?? 0) + 1;
    counts.set(path, count);
    active++; peak = Math.max(peak, active);
    res.on('close', () => active--);
    let status = 200, delay = 20;
    if (path === '/limited' && count === 1) { status = 429; res.setHeader('Retry-After', '1'); }
    if (path === '/busy') status = 503;
    if (path === '/missing') status = 404;
    if (path === '/long-wait') { status = 429; res.setHeader('Retry-After', '60'); }
    if (path === '/slow') delay = 200;
    setTimeout(() => {
      if (res.destroyed) return;
      res.writeHead(status, { 'content-type': 'application/json' });
      res.end(path === '/bad-json' ? '{broken' : JSON.stringify({ path, attempt: count }));
    }, delay);
  });
  return { server, counts, getPeak: () => peak };
}
if (process.argv[1] && fileURLToPath(import.meta.url) === resolve(process.argv[1])) {
  createMock().server.listen(8788, '127.0.0.1', () => console.log('mock: http://127.0.0.1:8788'));
}
第三步:保存结果,并支持失败补跑
将下面保存为 run.mjs。不传参数时用六个测试 URL;第一个参数可以指定 URL 数组 JSON 文件,第二个参数是输出文件前缀。补跑换个前缀,就能保留上一轮的记录。
import { readFile, writeFile } from 'node:fs/promises';
import { collect } from './client.mjs';

const base = 'http://127.0.0.1:8788';
const defaults = ['/ok/1', '/limited', '/missing', '/busy', '/bad-json', '/ok/2']
  .map(path => base + path);
const urls = process.argv[2]
  ? JSON.parse(await readFile(process.argv[2], 'utf8')) : defaults;
if (!Array.isArray(urls) || urls.some(x => typeof x !== 'string')) {
  throw new Error('input must be an array of URL strings');
}
const prefix = process.argv[3] ?? 'batch';
const results = await collect(urls, { concurrency: 3, attempts: 3 });
await writeFile(`${prefix}-results.json`, JSON.stringify(results, null, 2) + '\n');
await writeFile(`${prefix}-failed.json`, JSON.stringify(results.filter(x => !x.ok).map(x => x.url), null, 2) + '\n');
console.table(results.map(({ url, ok, error }) => ({ url, ok, error: error ?? '' })));
if (results.some(x => !x.ok)) process.exitCode = 1;
把三个文件放在同一目录。终端一执行:
node mock.mjs终端二进入同一目录执行:
node run.mjs
# 检查 batch-results.json 和 batch-failed.json
# 修复接口或输入后,仅补跑失败项:
node run.mjs batch-failed.json retry
第一轮应得到 3 项成功、3 项失败,失败清单包含 missing、busy 和 bad-json。只要有失败,脚本的退出码就是 1,文件仍会写出,这方便让计划任务识别本次未全部完成。模拟服务的这三个错误不会自行恢复,所以直接补跑仍会失败,这是预期结果。
本地演示文件直接覆盖同名前缀的旧文件;重要数据可以按批次使用不同前缀,并参考同目录临时文件加原子替换保存。当前实现把结果放在内存里,全部完成后落盘,不支持进程中断后的自动续跑;大数据量应改成流式输入、逐条持久化和持久队列。
我实际做了哪些检查
除了运行上面的命令,我还使用临时端口启动模拟服务做了断言。以下次数来自本机测试,反映的是这个 mock 的行为,不是对真实 API 的性能测量。
| 场景 | 服务端观察 / 结果 |
|---|---|
| 六项混合任务 | 并发峰值 3,结果仍按输入 URL 排列 |
| 先 429 后成功 | 请求 2 次,整轮耗时至少包含要求的 1 秒等待 |
| 持续 503 | 请求 3 次后记录失败 |
| 404、无效 JSON | 各请求 1 次,不重试 |
| 要求等待 60 秒,任务预算 500 毫秒 | 只请求 1 次,报告等待超过预算 |
| 200 毫秒慢响应,单次超时 30 毫秒 | 请求 3 次后报告超时失败 |
| 空列表、非法并发数 | 分别返回空结果、拒绝无效参数 |
换成自己的业务接口,还要做哪些决定
先确认接口的配额范围。如果 429 针对整个账号,当前的“每任务等待”仍可能让其他 worker 继续访问同一账号。此时应该把冷却截止时间放在共享调度器里,并在取任务前统一检查;固定的每秒配额则适合再加令牌桶。多进程运行还需要共享的配额存储。
这版只适用于已经获准访问、返回体规模可控的只读接口。成功响应的 JSON 没有限制字节数,也没校验业务字段;正式同步前应补上响应大小、结构验证、脱敏日志和认证配置。不要直接拿来下载任意来源的大文件。
重试 GET 通常比较容易处理;换成下单、扣费、发文等写入操作,需要接口级幂等键或先查询结果,超时不能证明远端没有执行。本文没有做写入重试。即使只读采集,失败清单也要先看原因:404 往往需要修输入,JSON 错误可能要修上游数据,盲目补跑不一定有帮助。
我会先把这套流程用在一次性、小批量的只读同步上。等任务量增加,再把同样的规则放进持久队列:并发、退避和失败原因要能解释,任务中断也得能继续。
🎨 原创不易,支持请点赞、转载请注明本文作者为老K